protocol
ByteBufUtils.writeString
writeString 方法用于将一个字符串写入到一个 ByteBuf 对象中,字符串的长度采用可变长整数(Varint)编码。
Varint 编码:通过使用字节的最高位标记是否有后续字节来表示整数。将数值分成 7 位一组,从低位开始,每组最高位为 1 表示还有后续字节,为 0 表示结束。
如果预留字节数过多,调整写指针位置,写入实际长度,并清理多余空间
预留字节数会过多的情况一般发生在字符串的实际编码长度比预估的最大字节数少。
使用 ByteBufUtil.utf8MaxBytes(value) 计算字符串在 UTF-8 编码下的最大可能字节数。这是一个最坏情况估计。
总结 writeString 方法
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
public static void writeString(ByteBuf byteBuf, String value) {
    if (StringUtils.isEmpty(value)) {
        writeInt(byteBuf, 0);
        return;
    }

    // 预估需要写入的字节数,并预留位置
    var maxLength = ByteBufUtil.utf8MaxBytes(value);
    var writeIntCountByte = writeInt(byteBuf, maxLength);

    var length = byteBuf.writeCharSequence(value, StringUtils.DEFAULT_CHARSET);

    var currentWriteIndex = byteBuf.writerIndex();

    // 因为写入的是可变长的int,如果预留的位置过多,则清除多余的位置
    var padding = writeIntCountByte - writeIntCount(length);
    if (padding == 0) {
        byteBuf.writerIndex(currentWriteIndex - length - writeIntCountByte);
        writeInt(byteBuf, length);
        byteBuf.writerIndex(currentWriteIndex);
    } else {
        var retainedByteBuf = byteBuf.retainedSlice(currentWriteIndex - length, length);
        byteBuf.writerIndex(currentWriteIndex - length - writeIntCountByte);
        writeInt(byteBuf, length);
        byteBuf.writeBytes(retainedByteBuf);
        ReferenceCountUtil.release(retainedByteBuf);
    }
}
方法分解
- 检查字符串是否为空:
1
2
3
4
if (StringUtils.isEmpty(value)) {
    writeInt(byteBuf, 0);
    return;
}
- 如果字符串为空,写入长度
0并返回。
- 如果字符串为空,写入长度
- 预估最大字节数并预留位置:
1
2
var maxLength = ByteBufUtil.utf8MaxBytes(value);
var writeIntCountByte = writeInt(byteBuf, maxLength);
- 计算字符串在 UTF-8 编码下的最大字节数。
- 使用
writeInt方法写入预估的最大长度并预留空间。
- 写入字符串内容:
1
2
var length = byteBuf.writeCharSequence(value, StringUtils.DEFAULT_CHARSET);
var currentWriteIndex = byteBuf.writerIndex();
- 将字符串内容以 UTF-8 编码写入
byteBuf,记录实际写入的字节数length和当前写指针位置。
- 将字符串内容以 UTF-8 编码写入
- 处理预留空间和实际所需空间的差异:
1
2
3
4
5
6
7
8
9
10
11
12
var padding = writeIntCountByte - writeIntCount(length);
if (padding == 0) {
    byteBuf.writerIndex(currentWriteIndex - length - writeIntCountByte);
    writeInt(byteBuf, length);
    byteBuf.writerIndex(currentWriteIndex);
} else {
    var retainedByteBuf = byteBuf.retainedSlice(currentWriteIndex - length, length);
    byteBuf.writerIndex(currentWriteIndex - length - writeIntCountByte);
    writeInt(byteBuf, length);
    byteBuf.writeBytes(retainedByteBuf);
    ReferenceCountUtil.release(retainedByteBuf);
}
- 如果预留的字节数和实际需要的字节数一致,直接写入实际长度。
- 如果预留字节数过多,调整写指针位置,写入实际长度,并清理多余空间。
Varint 编码
writeInt方法和writeIntCount方法使用 Varint 编码来存储整数长度。- Varint 编码通过使用字节的最高位指示是否有后续字节,能有效地减少较小整数的字节占用。
writeString 的 ByteBuf 内容
- 字符串长度(可变长整数编码)
- 字符串数据(按指定字符集编码)
示例
假设要写入字符串 “Hello”:
- 字符串长度:
- “Hello” 的字节长度是 5。
- 5 的 Varint 编码是
[05]。
- 字符串数据:
- “Hello” 的 UTF-8 编码是
[48 65 6c 6c 6f]。
- “Hello” 的 UTF-8 编码是
因此,byteBuf 的内容是:
1
[05] [48 65 6c 6c 6f]
ByteBufUtils.wirteXxxBox & readXxxBox
这些方法是对基本类型进行装箱拆箱,加入了空值的判断:若为空写入各类型默认值。
HashMapIntShort
对基本类型的支持,避免了自动装箱和拆箱,提高了性能。适用于需要频繁操作基本类型键值对的场景,如游戏开发中的状态管理、性能敏感的实时数据处理等。
HashMapIntShort 提供了一种高效的基本类型映射实现,避免了 Java 集合框架中 HashMap<Integer, Short> 的性能开销。通过自定义数组和线性探测解决冲突,实现了高效的插入、查找和删除操作。
HashMapIntShort 类总结
HashMapIntShort 是一个实现了 Map<Integer, Short> 接口的自定义哈希映射类。该类主要特点是:
- 内部使用数组存储键、值和状态,并通过线性探测解决冲突。
- 支持基本类型操作,避免了自动装箱和拆箱,提高了性能。
类的结构和方法解析
1. 属性
int[] keys:存储键的数组。short[] values:存储值的数组。byte[] statuses:存储状态的数组(FREE, FILLED, REMOVED)。int size:当前映射中的元素数量。int maxSize:达到此大小后需要扩展数组容量。int mask:用于计算索引的掩码。
2. 构造方法
HashMapIntShort():默认构造方法,使用默认容量初始化。HashMapIntShort(int initialCapacity):指定初始容量进行初始化。
3. 初始化和扩展容量
initCapacity(int capacity):根据容量计算掩码,并初始化数组。ensureCapacity():检查当前大小是否超过最大大小,若超过则进行扩容。rehash(int newCapacity):扩容并重新散列所有元素到新的数组。
4. 核心操作方法
size():返回当前映射中的元素数量。isEmpty():判断映射是否为空。containsKey(Object key)/containsKeyPrimitive(int key):判断是否包含指定的键。containsValue(Object value)/containsValuePrimitive(short value):判断是否包含指定的值。get(Object key):获取指定键对应的值。put(Integer key, Short value)/putPrimitive(int key, short value):插入键值对。remove(Object key)/removePrimitive(int key):移除指定键对应的键值对。clear():清空映射。
5. 辅助方法
hashIndex(int key):计算键的散列索引。set(int index, int key, short value, byte status):在指定索引处设置键、值和状态。indexOf(int key):查找键所在的索引。probeNext(int index, int mask):线性探测解决冲突。calcMaxSize(int capacity):计算允许的最大元素数量,通常是容量的 75%。
6. 内部类
PrimitiveEntry:实现Map.Entry<Integer, Short>,表示映射中的键值对。FastIterator:用于快速遍历映射中的键值对。KeySet:实现AbstractSet<Integer>,表示所有键的集合。ValueSet:实现AbstractSet<Short>,表示所有值的集合。EntrySet:实现AbstractSet<Map.Entry<Integer, Short>>,表示所有键值对的集合。
7. 例子和使用场景
该类的主要优势在于对基本类型的支持,避免了自动装箱和拆箱,提高了性能。适用于需要频繁操作基本类型键值对的场景,如游戏开发中的状态管理、性能敏感的实时数据处理等。
在 HashMapIntShort 类中,keys、values 和 statuses 数组分别起着以下作用,并保存特定的内容:
1. keys 数组
- 作用:保存哈希映射中的键。
- 内容:每个元素是一个键值对中的键(
int类型)。 - 代表:特定索引位置的键。例如,如果
keys[3] = 42,则表示索引 3 处的键是 42。
2. values 数组
- 作用:保存哈希映射中的值。
- 内容:每个元素是一个键值对中的值(
short类型)。 - 代表:与
keys数组对应索引位置的值。例如,如果values[3] = 100,则表示索引 3 处键 42 对应的值是 100。
3. statuses 数组
- 作用:保存哈希映射中每个槽位的状态。
- 内容:每个元素是一个表示状态的字节(
byte类型)。 - 代表:槽位的状态,有三种可能的值:
FREE(通常为 0):该槽位未使用。FILLED(通常为 1):该槽位已被填充,表示当前索引处有一个有效的键值对。REMOVED(通常为 2):该槽位曾经被使用过,但现在已被移除。
keys 数组用于存储所有的键,values 数组用于存储与这些键对应的值,而 statuses 数组用于表示每个槽位的状态。这三者共同作用,实现了哈希映射的数据存储和冲突解决。
protocol
协议号最大值为2^15-1
IPacket
1
2
3
4
5
6
7
8
9
10
11
12
13
14
//所有协议类都必须实现这个接口,协议类必须是简单的javabean,
//不能继承任何其它的类,但是可以继承接口
public interface IPacket {
    /**
     * 这个类的协议号,重写这个方法,使用多态获取协议号,可以微弱的提高一点性能
     * <p>
     * 子类可以不用重写这个方法,也能够通过反射自动获取到PROTOCOL_ID这个协议号,序列化一次对象只会调用一次,性能损失很小
     *
     * @return 协议号Id
     */
    default short protocolId() {
        return ProtocolManager.protocolId(this.getClass());
    }
}
定义协议号
有两种方式定义:
-
在协议类内定义协议号常量:
1
2
3
4
5
public class MyObjectA implements IPacket {

    public static final transient short PROTOCOL_ID = 2;
    ...
}
-
使用
@Protocol注解:1 2 3 4
@Protocol(id = 1000) public class BigPacket implements IPacket { public int[] a = new int[10_0000]; }
管理协议的类
-
protocol.ProtocolManager: 类中的方法和变量都是
static,可以直接通过类名访问,而不需要创建类的实例。负责协议数据包的(反)序列化、协议集的初始化(注册)等。 -
protocol.registration.ProtocolAnalysis:类中的方法和变量都是
static,可以直接通过类名访问,而不需要创建类的实例。负责协议集的校验、协议信息的解析等。
ProtocolManager
- ProtocolManager.write:首先写入协议号(short 类型),然后调用对应协议的 write 方法将数据包内容写入缓冲区。
- ProtocolManager.read:首先读取协议号(short 类型),然后调用对应协议的 read 方法从缓冲区中读取数据包内容。
协议初始化
这里会对所需要初始化的IPacket协议类在ProtocolManager中生成对应的ProtocolRegistration,且其实现了具体的序列化方法。
例如:ProtocolManager.initProtocol(Set.of(BigPacket.class));
初始化协议的调用栈:
ProtocolManager.initProtocol(Set<Class<?» protocolClassSet, GenerateOperation generateOperation)
ProtocolAnalysis.analyze(Set<Class<?» protocolClassSet, GenerateOperation generateOperation)
ProtocolAnalysis.getProtocolIdAndCheckClass(clazz)
有如下检查,返回协议类对应的协议号。
1
2
3
4
5
6
7
8
9
// 是否为一个简单的javabean
// 是否实现了IPacket接口
// 不能是泛型类
// 应有PROTOCOL_ID属性
// 应有PROTOCOL_METHOD属性
// 必须要有一个空的构造器
// 不能同时使用PROTOCOL_ID(必须是常量)和@Protocol定义协议号
// 验证protocol()方法的返回是否和PROTOCOL_ID相等
// 可能通过xml的方式注册协议,xml注册协议不需要注解和PROTOCOL_ID协议字段号
ProtocolAnalysis.initProtocolClass
将协议类和协议 id放入ProtocolManager的protocolIdMap(key 为协议类,value 为协议 id)和protocolIdPrimitiveMap(key 为协议类的 hash,value 为协议 id)
在此校验协议号不能重复
由于以下代码,ProtocolAnalysis 可以直接访问 ProtocolManager 下的静态成员
import static com.zfoo.protocol.ProtocolManager.*;
parseProtocolRegistration
parseProtocolRegistration 用于解析一个类的协议注册信息,并将其封装成 ProtocolRegistration 对象返回。
流程如下:
1
2
3
4
5
6
7
8
9
10
11
//获取给定类对应的协议 ID
//排序需要被序列化的属性customFieldOrder(clazz),(所有的协议里的发送顺序都是按字段名称排序)
  //属性的访问修饰符不能为final、必须是public或者private
  //解析版本兼容性属性(@Compatible注解),不能有相同的Compatible顺序
  // 默认无法兼容的协议变量名称从小到大排序,可兼容的协议变量默认都添加到最后
//遍历需要被序列化的属性,转换为字段注册对象IFieldRegistration,添加到List中
  //基本类型,数组,Set、List、Map->xxxFiled
  //协议引用变量ObjectProtocolField
//反射获取该类的默认构造函数,确保能够访问私有构造函数
//创建并返回一个新的 ProtocolRegistration 对象,设置其属性值,
//包括协议 ID、构造函数、字段信息等。
enhance(generateOperation, enhanceList)
1
2
3
4
5
6
7
8
9
//检查协议类和模块格式,然后生成协议文件
enhanceProtocolBefore(generateOperation);
//对传入的协议注册对象列表中的每个对象进行增强,
//然后初始化各个子协议成员变量
enhanceProtocolRegistration(enhanceList);
//根据是否使用了高性能的 HashMap 进行了 protocolIdMap 和 protocolIdPrimitiveMap 的清理,
//然后清理了一些其他的临时数据和工具类,
//最后根据生成的目标语言进行相应的清理操作
enhanceProtocolAfter(generateOperation);
ClassPool是 javassist 库中的一个重要类,用于管理类的池。它提供了一种机制,可以动态地创建新的类、加载类、修改类,并在运行时生成新的类。以下是关于ClassPool的一些重要概念和功能:
- 类池管理:
ClassPool实例维护了一个类的集合,称为类池。这些类可以是已经存在于类路径上的类,也可以是动态创建的类。- 动态类创建:
ClassPool可以用于动态地创建新的类。通过调用makeClass()方法,可以在类池中创建一个新的空类。- 类加载:
ClassPool可以加载类路径上已经存在的类。它可以通过get()方法从类路径上加载一个已有的类。- 类修改:
ClassPool可以用于修改已有类的字节码。它可以通过加载已有类,获取其CtClass对象,然后对其进行修改,最后将修改后的类重新加载到类池中。- 类转换:
ClassPool可以将CtClass对象转换为Class对象,以便在运行时实例化类。- 类的存储:
ClassPool通常与其他 javassist 类一起使用,如CtClass、CtConstructor、CtMethod等。这些类用于表示已经加载到类池中的类、构造器、方法等。总的来说,
ClassPool提供了一种在运行时创建、加载、修改和管理类的机制,使得 Java 程序可以更加灵活地进行类的操作和动态生成类的行为。
collection
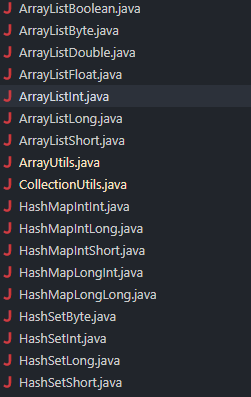
实现了一系列的常用类型的集合(实现接口时预定义了泛型)以及一些工具类